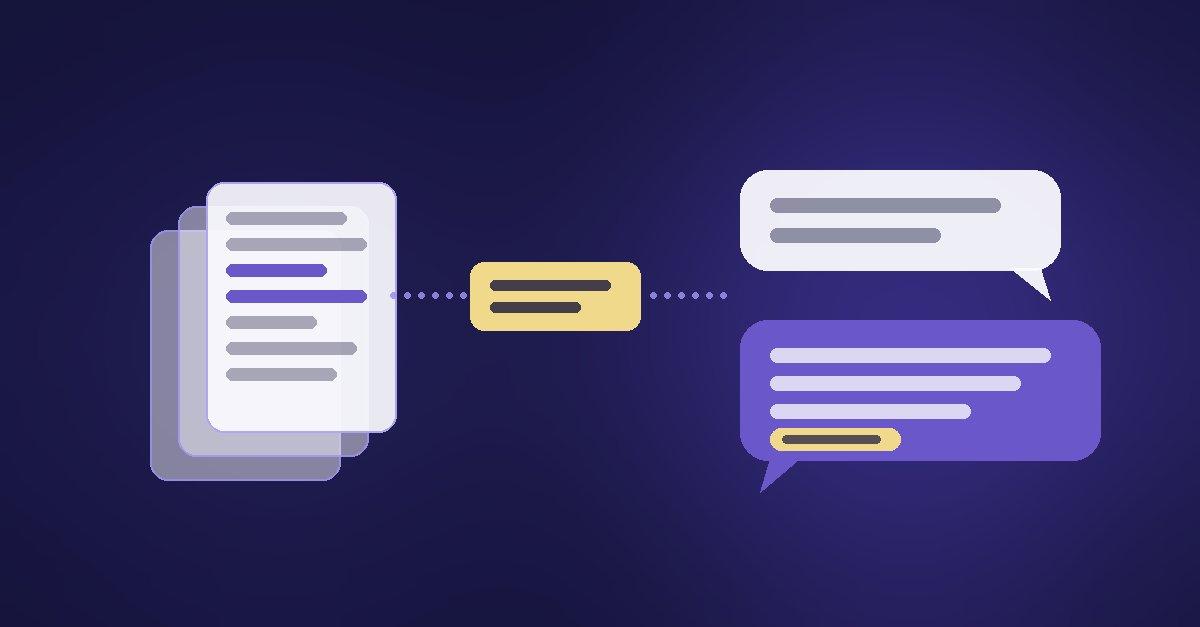
Un chatbot RAG est un assistant qui répond à partir de vos documents : procédures, fiches produits, notices, contrats types, historique du support. Il retrouve d'abord les passages utiles, puis un modèle d'IA rédige la réponse à partir de ces passages et cite ses sources. C'est ce qui le distingue d'un ChatGPT générique, qui répond de mémoire. Ce guide explique quand ce type d'assistant vaut l'investissement, ce qui fait la qualité de ses réponses, ce qu'il coûte et les questions à poser avant de lancer le projet.
Comment fonctionne un chatbot RAG ?
RAG signifie Retrieval-Augmented Generation, en français génération augmentée par la recherche. Le principe tient en deux temps.
- Préparation, une fois puis à chaque mise à jour. Les documents sont découpés en passages, chaque passage est converti en vecteur (un embedding, une représentation numérique de son sens) et rangé dans un index.
- À chaque question. La question est convertie de la même façon, l'index renvoie les passages les plus proches, et le modèle d'IA rédige la réponse en s'appuyant uniquement sur ces passages.
Le modèle n'apprend rien de vos documents : il les lit au moment de répondre. Ajouter une procédure ou retirer une notice obsolète suffit donc à mettre l'assistant à jour, sans réentraînement.
Quand un chatbot RAG est-il utile ?
Il est rentable quand la même information est cherchée souvent, par beaucoup de personnes, dans une documentation trop volumineuse pour être connue par cœur. Les cas les plus courants :
- Service client : répondre aux questions récurrentes sur un produit, une commande ou un contrat, et passer la main à un humain pour le reste.
- Support interne : procédures qualité, règles RH, documentation technique, consignes de sécurité, accessibles en langage naturel.
- Aide intégrée à un logiciel : l'utilisateur pose sa question dans l'application plutôt que de chercher dans la documentation.
- Équipes commerciales : retrouver vite une fiche technique, une référence ou une clause d'un contrat type.
À l'inverse, si vos questions portent sur des données qui changent à chaque minute (stocks, statut d'une commande), il faut connecter l'assistant à vos outils par API ou via un serveur MCP, pas seulement indexer des documents. Et si l'assistant doit agir (créer un ticket, préparer un devis), on parle plutôt d'un assistant IA interne.
Chatbot RAG, ChatGPT d'entreprise ou modèle entraîné ?
Les trois options répondent à des besoins différents :
| Option | Pour quoi | Limites |
|---|---|---|
| ChatGPT, Copilot ou Claude en offre entreprise, avec vos fichiers | Usage individuel, peu de documents, besoin immédiat | Pas de contrôle fin des droits d'accès, difficile à intégrer à votre site ou à vos outils, dépendance à un éditeur |
| Chatbot RAG sur mesure | Grande base documentaire, accès par profil, intégration au site, à l'application ou aux outils internes | Demande un projet : préparation des documents, développement, suivi de la qualité |
| Modèle entraîné (fine-tuning) | Imposer un style, un format ou un vocabulaire très spécifique | Coûteux, figé à la date de l'entraînement, ne cite pas ses sources |
Pour la plupart des PME, la question se pose entre les deux premières lignes. Si quelques personnes interrogent quelques dizaines de documents, une offre du marché suffit souvent : commencez par là. Le sur mesure se justifie quand l'assistant s'adresse à vos clients, quand tout le monde ne doit pas voir les mêmes documents, ou quand il doit vivre dans vos propres outils.
Ce qui fait la qualité des réponses
Le choix du modèle d'IA compte moins qu'on ne le croit. Quatre éléments font l'essentiel de la différence.
Des documents à jour et bien découpés
Un assistant qui indexe trois versions d'une même procédure répondra avec la mauvaise une fois sur trois. Avant d'indexer, il faut décider quels documents font foi, qui les met à jour et comment les anciennes versions sortent de l'index. Le découpage compte aussi : un tableau coupé au milieu ou une procédure séparée de son titre donnent des passages inutilisables.
Des droits d'accès respectés
Si un document RH ou un contrat client n'est pas visible par tout le monde dans votre entreprise, il ne doit pas l'être via l'assistant. Le filtrage doit se faire au moment de la recherche, selon le profil de la personne qui pose la question, et non en demandant au modèle de « ne pas en parler ».
Des réponses sourcées, et le droit de dire « je ne sais pas »
On contraint le modèle à répondre à partir des passages retrouvés, à citer les documents utilisés et à dire clairement quand l'information n'y figure pas. Un assistant qui avoue ne pas savoir inspire plus confiance qu'un assistant qui invente avec aplomb.
Un jeu de questions de référence
C'est l'outil le plus négligé. Une centaine de vraies questions, avec la réponse attendue et le document qui la contient, rejouées à chaque changement de modèle, de consignes ou de documents. Sans lui, impossible de savoir si une modification améliore l'assistant ou le dégrade.
Données personnelles et confidentialité
Vos documents contiennent souvent des noms, des adresses ou des informations clients. Ce n'est pas bloquant, mais cela se décide dès la conception :
- Où tourne le modèle ? Chez un fournisseur américain, chez un fournisseur européen, ou sur votre propre infrastructure avec un modèle open source.
- Que lui envoie-t-on ? Un modèle d'extraction d'entités exécuté localement, comme GLiNER, peut détecter et masquer les données personnelles avant tout appel à un modèle externe.
- Qui est responsable de quoi ? Le prestataire qui héberge l'assistant traite vos données pour votre compte : un accord de sous-traitance au sens du RGPD doit préciser les mesures de sécurité, la localisation des données et les fournisseurs utilisés.
- L'utilisateur sait-il qu'il parle à une IA ? Le règlement européen sur l'IA impose de l'en informer. Un simple message au début de la conversation suffit en général.
Enfin, pensez à la sortie : les embeddings calculés par un fournisseur ne sont pas réutilisables chez un autre. Une architecture qui isole le modèle derrière une couche d'abstraction permet d'en changer sans tout redévelopper, comme nous l'expliquons dans notre article sur une stack IA sans dépendance à un éditeur.
Combien coûte un chatbot RAG ?
Le budget se compose de trois postes :
| Poste | Ce qu'il couvre | Comment il varie |
|---|---|---|
| Développement | Conception, chaîne d'ingestion des documents, recherche, interface, droits d'accès, jeu de questions de référence | Volume et diversité des documents, nombre de sources, droits d'accès, canal de diffusion |
| Usage du modèle | Le coût de chaque question envoyée au modèle d'IA | Nombre de questions, longueur des passages transmis, modèle choisi |
| Hébergement et suivi | Index, serveurs, mises à jour, surveillance de la qualité | Volume indexé, disponibilité attendue, hébergement cloud ou local |
Les prix publiés par les prestataires français donnent des ordres de grandeur : une preuve de concept à partir de 3 000 € environ, et de 9 000 à 28 000 € pour un assistant complet destiné à une PME. Ces chiffres viennent de prestataires qui vendent eux-mêmes ces projets ; ils servent de repère, pas de barème.
Chez KODY, une première version sur vos documents démarre à 5 000 € HT, conception comprise : un périmètre de documents réduit, une interface de chat et un jeu de questions de référence pour juger la qualité avant d'élargir. Le prix du développement est fixé à la fin de la conception et ne bouge plus ensuite. Les coûts d'usage du modèle sont estimés pendant cette conception, avant de choisir le fournisseur.
Bon à savoir : demandez toujours le coût mensuel estimé pour votre volume de questions, pas seulement le prix du développement. Un modèle plus puissant que nécessaire peut multiplier la facture d'usage sans améliorer les réponses.
Comment se déroule un projet ?
- Inventaire des contenus. Quels documents, dans quels formats, à quelle fréquence de mise à jour, et qui a le droit de les voir. C'est souvent l'étape qui décide de la qualité finale.
- Prototype sur un périmètre réduit. Un premier lot de documents indexé, confronté à de vraies questions de vos équipes ou de vos clients. On juge la pertinence avant d'élargir.
- Industrialisation. Ingestion automatique des nouveaux documents, gestion des droits, interface définitive, intégration à votre site ou à vos outils.
- Mise en production et suivi. Analyse des questions posées, des réponses jugées insuffisantes et des documents manquants ; le jeu de référence est rejoué à chaque évolution.
Les questions à poser à un prestataire
- Comment mesurez-vous la qualité des réponses ? Sans jeu de questions de référence, la réponse est « au ressenti ».
- Comment sont gérés les droits d'accès aux documents ? Le filtrage doit se faire à la recherche, selon l'utilisateur.
- Où sont hébergés les documents, l'index et le modèle ? Et quels fournisseurs voient passer vos données ?
- Que se passe-t-il si je veux changer de modèle ou de prestataire ? Qui détient le code, l'index et les documents préparés ?
- Quel est le coût mensuel pour mon volume de questions ? Développement, usage du modèle et hébergement, séparément.
- Comment l'assistant se met-il à jour quand un document change ? Automatiquement, ou à la main ?
Si vous ne savez pas encore quel cas d'usage traiter en premier, ou si l'IA est vraiment la bonne réponse à votre problème, un diagnostic IA permet de le décider avant d'engager un développement. Et si vous avez déjà identifié vos documents et vos utilisateurs, vous pouvez nous décrire votre projet de chatbot RAG : le premier échange est gratuit.